
· HARUBOUYA · dataflow · 11 min read
GCPでのデータ取り込みを、どういう構造にしているか
生データ層・中間層・提供層の3層構成、取り込みの3経路、冪等性の担保、コストと失敗の監視までまとめます。BigQueryを中心にしたデータ取り込みの型を整理します。
複数のサービスからデータを集めてくると、取り込み方がサービスごとにバラバラになります。数が増えたところで破綻し、誰も全体を把握できなくなります。
そうならないよう、取り込みの構造を先に決めて、新しい連携もその型に乗せます。ここでは実際に使っている構成を、固有の設定値を伏せた形で整理します。
3層に分ける
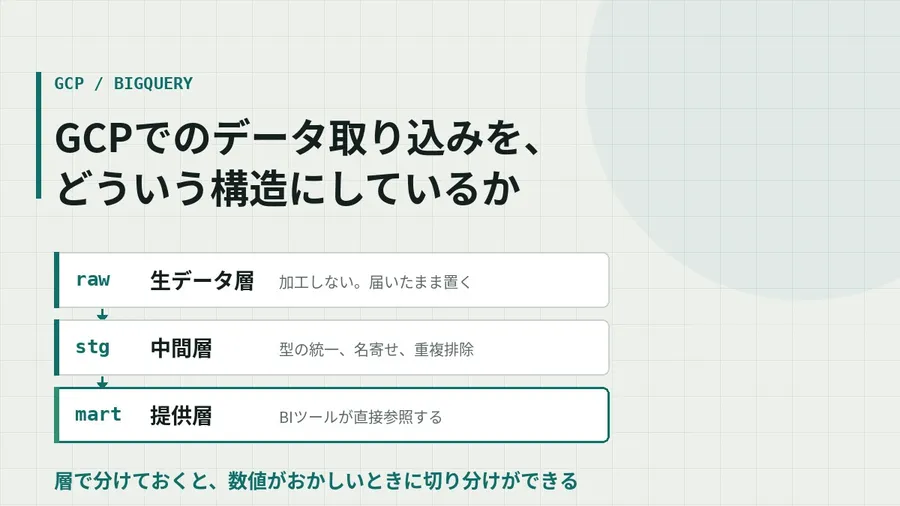
BigQuery のデータセットを役割ごとに3つに分けます。
外部サービス / ファイル
        ↓
[ raw ]   生データ層
          加工しない。届いたまま置く
        ↓
[ stg ]   中間層
          型の統一、名寄せ、重複排除
        ↓
[ mart ]  提供層
BIツールや連携先が直接参照する分ける理由は、数値がおかしいときに切り分けができることです。
| 症状 | 見る場所 | 分かること |
|---|---|---|
| 数字が出ません | raw | そもそも届いていないのか |
| 数字が変 | stg | 加工で壊れたのか |
| 表示が変 | mart | 定義の問題か、BI側の問題か |
層を分けていないと、この切り分けに毎回時間を取られます。3つのデータセットを作るだけで済む話なので、最初にやっておきます。
raw は絶対に加工しません。ここを「ついでに整形」し始めると、届いたデータの原形が失われ、比較対象がなくなります。
取り込みの3経路
外部からデータが入ってくる経路は、実質3種類に収まります。
経路1:GCSからのバッチロード
ファイルを GCS に置き、BigQuery に読み込みます。CSV や JSON で出力されるデータはこれです。
利点は、失敗してもやり直せることです。 読み込みに失敗しても、ファイルは GCS に残っています。提供元に再送を依頼せずに読み直せます。
バケットは用途ごとに分け、ライフサイクルルールを最初に設定します。
30日経過  → Nearline へ移行
90日経過  → 削除
ファイルがたまり続けると、ストレージ費用が静かに増えます。後から棚卸しするより、最初にルールを置くほうが安いです。
経路2:外部サービスからの直接書き込み
連携先のサービスが、こちらの BigQuery に直接書き込みます。相手にサービスアカウントを渡して権限を付ける形です。
権限はデータセット単位で付けます。プロジェクト全体に編集者を渡すと、連携と無関係なデータセットまで書き換えられる状態になります。
書き込み先は raw の中でも専用のデータセットに隔離します。外部から書かれる領域と、社内で作る領域を混ぜないでください。
経路3:スケジュールドクエリ
BigQuery 内で完結する定期処理です。他システムから来たデータを整形して次の層に渡します。
素朴に組むと依存関係が管理できなくなります。変換処理は後述の Dataform に寄せ、スケジュールドクエリは単発の用途に留めます。
冪等性を最初に決める
同じ処理を2回実行しても、結果が同じになることです。 これが担保されていないと、再実行が怖くてできなくなります。
取り込みで一番多い事故が「再実行したら件数が2倍になった」です。
対処は、日付でパーティションを切り、対象日のパーティションだけを入れ替えます。
-- 対象日だけを置き換える。何度実行しても結果は同じ
CREATE OR REPLACE TABLE `プロジェクト.raw.テーブル$20260911`
AS
SELECT ...
FROM  外部ソース
WHERE event_date = '2026-09-11';
全件を書き直さないのでコストも抑えられます。キーで突き合わせる必要があるなら MERGE を使いますが、まずはパーティション単位の入れ替えで足りることが多いです。
Append は避けます。速いですが、再実行のたびに重複します。遅れて届いたデータを取り直す運用と両立しません。
変換は Dataform に寄せる
stg と mart の変換は Dataform にまとめます。SQL をファイルとして管理し、依存関係から実行順を自動で決める仕組みです。
得られるものは3つです。
依存関係が明示されます。 どのテーブルがどれを参照しているかが定義から分かります。テーブルを直す前に、影響範囲を確認できます。
アサーションが書けます。 「このカラムは NULL であってはならない」「このキーは重複してはならない」を定義に書いておくと、条件を満たさないときに処理が止まります。壊れたデータが下流に流れません。
Git で履歴が残ります。 誰がいつ何を変えたかが追えます。定義の変更と数値の変化を突き合わせられます。
運用上の注意点として、開発ワークスペースは Git から手動で取り込まないと最新になりません。ブラウザ上で編集していると、リポジトリ側の変更が反映されていない状態に気づきにくいです。作業前に取り込む習慣にしておきます。
命名規則
名前で「どこにあるか」「何者か」が分かる状態にします。
| 対象 | 規則 | 例 |
|---|---|---|
| データセット | 層の名前をそのまま使います | raw / stg / mart |
| raw のテーブル | 提供元 + 内容 | <提供元>_<内容> |
| stg のテーブル | 内容 + 粒度 | <内容>_daily |
| mart のテーブル | 用途が分かる名前 | <レポート名>_summary |
| 日付カラム | 全テーブルで同じ名前に揃えます | event_date |
日付カラムの名前を揃えるのが地味に効きます。テーブルごとに date dt event_date が混在していると、結合のたびに定義を確認することになります。
監視は BigQuery 自身で足りる
INFORMATION_SCHEMA を使えば、ジョブの実行履歴とスキャン量を SQL で取れます。
-- 直近7日の、処理量が多いジョブと失敗したジョブ
SELECT
  DATE(creation_time, 'Asia/Tokyo')                 AS run_date,
  job_id,
  user_email,
  ROUND(total_bytes_processed / POW(1024, 3), 2)    AS scanned_gb,
  TIMESTAMP_DIFF(end_time, start_time, SECOND)      AS duration_sec,
  error_result.reason                               AS error_reason
FROM `region-asia-northeast1`.INFORMATION_SCHEMA.JOBS_BY_PROJECT
WHERE creation_time >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
  AND job_type = 'QUERY'
  AND (error_result IS NOT NULL OR total_bytes_processed > 50 * POW(1024, 3))
ORDER BY run_date DESC, scanned_gb DESC;
これで次の2つが同時に見えます。
- 失敗したジョブ(
error_reasonが入っているもの) - 重いジョブ(スキャン量が閾値を超えたもの)
コストが跳ねたとき、原因のクエリを特定できます。費用の請求書を見てから調べ始めると、その月はもう終わっています。
あわせて、層ごとに件数の日次チェックを置きます。raw の件数が0なら取り込み失敗、raw はあるのに mart が0なら変換の失敗と、層で切り分けられます。
権限
サービスアカウントは用途ごとに分けます。1つを使い回すと、事故のときに影響範囲が特定できません。
| 用途 | 権限の範囲 |
|---|---|
| 外部サービスからの書き込み | raw の該当データセットのみ・編集者 |
| 変換処理 | raw 閲覧者 + stg / mart 編集者 |
| BIツールからの参照 | mart のみ・閲覧者 |
BIツールに raw を見せないのが要点です。加工前のデータを誰でも参照できる状態にすると、そこから直接レポートが作られ始めます。定義がバラバラなレポートが増える原因になります。
この構成にしている理由
| 決めごと | 効いてくる場面 |
|---|---|
| 3層に分けます | 数値がおかしいときの切り分け |
| raw は加工しません | 比較対象が残ります |
| GCS を挟みます | 取り込みの再実行 |
| パーティション単位の上書き | 再実行しても重複しません |
| 変換を Dataform に寄せます | 影響範囲の確認と履歴 |
| 命名規則を揃えます | 引き継ぎ |
| INFORMATION_SCHEMA で監視 | コストと失敗の早期発見 |
| 権限を用途別に分けます | 事故の影響範囲の限定 |
どれも作るときは手間に見えますが、効いてくるのは半年後、担当者が代わったときです。データ基盤は、作った本人がいなくなってからのほうが長く使われます。
参考になったら、いいねを押してください。