
· HARUBOUYA · dataflow · 9 min read
KARTEのデータをGCPに流すときの構成の決め方
KARTE Datahub と BigQuery をつなぐときに最初に決める、連携方式・リージョン・権限・書き込みモードの4点を整理します。
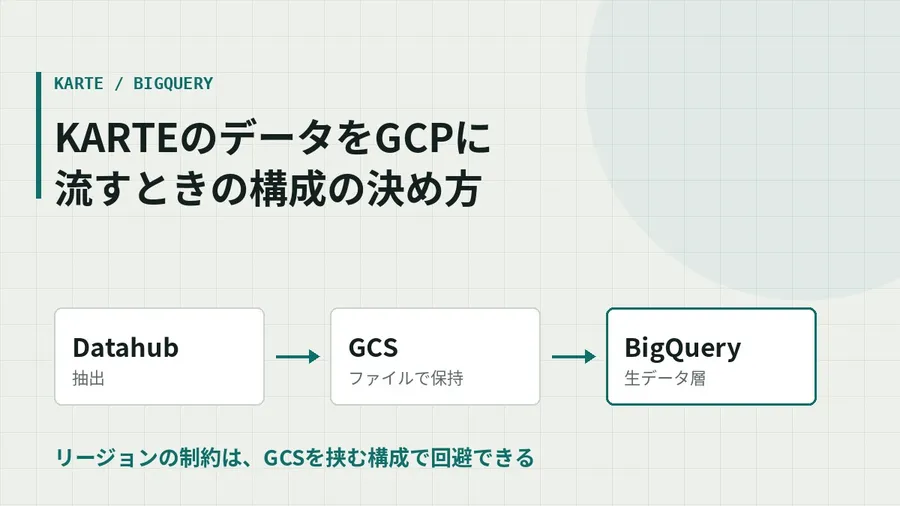
Web接客ツールでたまったデータを、自社のデータ基盤に集約したいです。KARTE を使っているなら、Datahub 経由で BigQuery につなぐことになります。
つなぐこと自体は難しくありません。ただし最初に決めておかないと後から直しづらい項目がいくつかあります。ここではその4点を整理します。
なお以下は一般的な構成の話で、特定の案件の設定値は含みません。
何を持ってくるのかを先に決める
KARTE 側にあるデータは大きく3種類です。用途が違うので、全部まとめて持ってこようとすると設計が崩れます。
| 種類 | 中身 | 主な使いみち |
|---|---|---|
| イベント | ページ閲覧、カート投入、購入などの行動ログ | 行動分析、セグメント作成 |
| ユーザー | 会員IDや属性に紐づく情報 | 他システムとの突合 |
| 接客の配信実績 | どの接客が誰にいつ出たか | 施策の効果測定 |
まず1種類から始めます。イベントが最も量が多く、設計の失敗が効いてくるので、行動分析が目的なら最初にここを通します。
1. 連携方式を選ぶ
主に3つの選択肢があります。
| 方式 | 概要 | 向いているケース |
|---|---|---|
| Datahub のジョブで BigQuery に書き込みます | Datahub 上でクエリを書き、結果を自社の BigQuery に出力 | 定期的に決まった形で取り込みます |
| GCS を経由します | 一度ファイルに出し、そこから BigQuery に読み込みます | 大量データ、再取り込みの可能性があります |
| Direct Link | Datahub の画面上で自社 BigQuery を参照します | KARTE 側の画面で分析を完結させたいです |
自社のデータ基盤に集約するのが目的なら、1つ目か2つ目です。GCS を挟む構成のほうが後から楽になることが多いです。理由は後述します。
2. リージョンを最初に確認する
ここが最大の落とし穴です。
**Datahub 側の BigQuery は US マルチリージョンに配置されています。**一方、日本国内向けのデータ基盤は asia-northeast1(東京)に置くことが多いです。
BigQuery はリージョンをまたいだデータセット間の直接クエリができません。つまり、Datahub 側のテーブルと自社の東京リージョンのテーブルを、1本のクエリで結合することはできません。
対処は2つです。
- 自社側のデータセットも US に作ります。結合は楽になりますが、他のデータが東京にある場合は同じ問題が別の場所で起きます
- 一度エクスポートしてから東京側に取り込みます。GCS を挟む構成がこれにあたります
どちらを選ぶかは、自社データ基盤の既存リージョンで決まります。すでに東京にデータ基盤があるなら、迷わず後者です。ここを確認せずに進めると、テーブルを作り直すことになります。
3. 権限は用途ごとに分ける
Datahub のサービスアカウントに対して、自社の GCP 側で権限を付与します。
| やりたいこと | 必要な権限 |
|---|---|
| 自社 BigQuery のデータを読みます | BigQuery データ閲覧者 |
| 自社 BigQuery にデータを書きます | BigQuery データ編集者 |
押さえておきたいのは次の3点です。
プロジェクト単位ではなくデータセット単位で付けます。プロジェクト全体に編集者を付けると、連携と無関係なデータセットまで書き換えられる状態になります。
連携用のデータセットを分けます。外部から書き込まれる領域と、社内で加工した結果を置く領域を分けておきます。事故の影響範囲が限定でき、権限も絞りやすいです。
誰がいつ付けたかを残します。権限は付けたまま忘れられます。付与の記録を残し、定期的に棚卸しします。
4. 書き込みモードを決める
Datahub から BigQuery に書き込むとき、3つのモードから選びます。
| モード | 挙動 | 使いどころ |
|---|---|---|
| Write if empty | テーブルが空のときだけ書きます | 初回投入。事故防止 |
| Append to table | 既存データの後ろに追加します | 日次の積み上げ |
| Overwrite table | テーブルごと入れ替えます | マスタ系、小さめのデータ |
Append と Overwrite の選択が、後の運用を決めます。
- Append は速いですが、同じジョブを2回走らせると重複します。再実行のたびに件数が増えます
- Overwrite は冪等(何度実行しても同じ結果)ですが、対象範囲が広いと毎回全件を書き直すことになり、コストと時間がかかります
現実的な落としどころは、日付でパーティションを切り、対象日のパーティションだけを Overwrite する構成です。再実行しても重複せず、全件を触らずに済みます。
全体像
上記を踏まえた、よく使う構成です。
KARTE Datahub
   ↓  ① 日次でクエリ実行、結果を GCS に出力
Google Cloud Storage(連携用バケット)
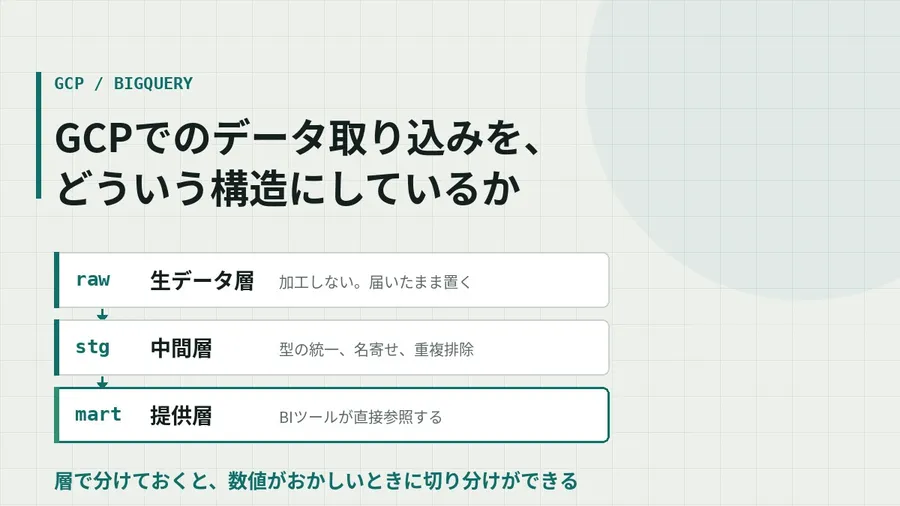
   ↓  ② BigQuery へ読み込み(生データ層)
BigQuery: raw データセット
   ↓  ③ 整形・結合(中間層)
BigQuery: mart データセット
   ↓
BIツール / 各種連携先3層に分ける理由は、取り込みの失敗と加工の失敗を切り分けられることです。数値がおかしいとき、生データ層を見れば「そもそも入ってきていない」のか「加工で壊れた」のかが即座に分かります。
GCS を挟む利点もここにあります。取り込みに失敗しても、ファイルは GCS に残っています。KARTE 側に再エクスポートを依頼せずに、そのまま読み込み直せます。
最初に決めることのまとめ
| 決めること | 判断の目安 |
|---|---|
| 連携するデータの種類 | まず1種類。イベントから始めます |
| 連携方式 | 自社基盤に集約するなら GCS 経由 |
| リージョン | 既存基盤が東京なら、エクスポート方式で揃えます |
| 権限 | データセット単位。連携用データセットを分離 |
| 書き込みモード | 日付パーティション単位の Overwrite |
| 層構成 | 生データ層と加工層を分けます |
運用に入ってからつまずく点は別の記事で扱います。
参考になったら、いいねを押してください。