
· HARUBOUYA · dataflow · 10 min read
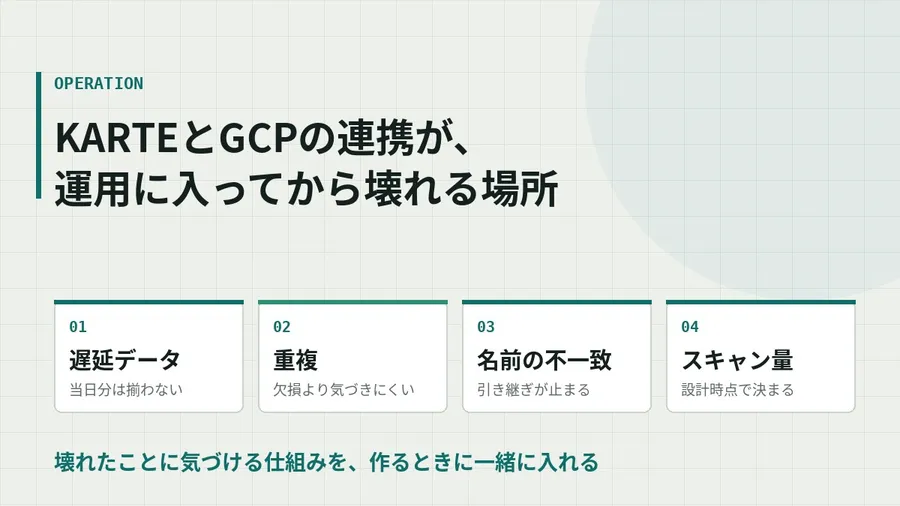
KARTEとGCPの連携が、運用に入ってから壊れる場所
遅延データ、重複、テーブル名の不一致、スキャン量の4つです。KARTE Datahub とBigQueryの連携を運用し続けるときに効いてくる勘所を整理します。
データ連携は、作った直後は動きます。壊れるのは運用に入ってからです。しかも壊れても業務は止まらないため、発覚が遅れます。
KARTE Datahub と BigQuery の連携で、実際に効いてくる勘所を整理します。前提となる構成の決め方は別の記事で扱っているので、ここでは運用の話に絞ります。
1. 当日のデータは揃わない前提で組む
行動ログは、その日のうちに全部が確定するわけではありません。ネットワークの都合で遅れて届くもの、集計側の処理が終わっていないものがあります。
深夜0時に前日分を取りに行くと、取りこぼします。
対処は2つです。
取得タイミングを遅らせます。前日分を朝に取りに行きます。ただし遅らせるほど、レポートの鮮度は落ちます。
過去分を定期的に取り直します。前日分に加えて、3日前から7日前までを毎日上書きし直します。遅れて届いたデータが後から埋まります。
後者を採るなら、Append ではなく日付パーティション単位の Overwrite が必須になります。Append で取り直すと、そのまま重複します。
2. 重複と欠損は、別々に検知する
連携の事故は2方向あります。
| 事故 | 症状 | 気づきやすさ |
|---|---|---|
| 欠損 | 件数が減る、0件になります | 気づきやすいです |
| 重複 | 件数が増えます | 気づきにくいです |
件数が増えているとき、人は「良いこと」だと思って見過ごします。売上が伸びたのか、二重計上なのか、数字だけでは判別できません。
最低限、次の2つをクエリで毎日確認します。
-- 日別の件数と、ユニークキーの重複有無
SELECT
  event_date,
  COUNT(*)                    AS rows_total,
  COUNT(DISTINCT event_id)    AS rows_unique,
  COUNT(*) - COUNT(DISTINCT event_id) AS duplicated
FROM `プロジェクト.データセット.テーブル`
WHERE event_date >= DATE_SUB(CURRENT_DATE('Asia/Tokyo'), INTERVAL 14 DAY)
GROUP BY event_date
ORDER BY event_date DESC;
duplicated が 0 でなければ重複です。件数が前週同曜日と大きく乖離していれば欠損の疑いがあります。曜日で比較するのがポイントで、平日と休日を並べると常に異常に見えます。
3. 名前の不一致が、引き継ぎを止める
連携が増えると、同じデータが違う名前で存在するようになります。
- 連携元(KARTE 側)での呼び名
- 取り込んだ生データ層での名前
- 加工後の名前
- BIツール上での表示名
この4つが揃っていないと、引き継ぎができなくなります。「この数字はどこから来ているのか」を追えるのが作った本人だけ、という状態になります。
対処は地味だが効果が大きいです。
対応表を1枚作ります。連携元の名称、生データ層のテーブル名、加工後のテーブル名、BI上の表示名を1行に並べます。スプレッドシート1枚で足ります。
命名規則を先に決めます。層ごとに接頭辞を揃える(生データ層は raw_、加工層は mart_ など)だけでも、どこにあるかが名前から分かります。
構成図を残します。文章より図のほうが伝わります。矢印がつながっていることが確認できれば十分で、凝ったものは要りません。
引き継ぎのときに一番時間を取られるのは、コードを読む作業ではなく**「どれとどれが同じものか」を突き止める作業**です。ここを先に潰しておきます。
4. スキャン量は設計で決まる
BigQuery の課金はスキャンしたデータ量で決まります。行動ログは量が多いので、ここを外すと後から効いてきます。
日付でパーティションを切ります。切っていないテーブルに WHERE event_date = ... を書いても、全件スキャンされます。逆に切ってあれば、対象日だけを読みます。
CREATE TABLE `プロジェクト.データセット.テーブル`
PARTITION BY event_date
CLUSTER BY user_id
AS SELECT ...;よく絞る列でクラスタリングします。ユーザーID や施策IDなど、WHERE に頻出する列を指定します。
SELECT * を書かないでください。BigQuery は列単位で課金されます。使わない列を読まないだけで、スキャン量が大きく下がります。
ビューの多段構成に注意します。ビューは実行のたびに元テーブルを読みます。3段重ねると、元テーブルを3回読む構成になっていることがあります。中間結果をテーブルとして保存したほうが安いケースは多いです。
5. 失敗に気づける状態を作る
ここまでの対策は、誰かが見ていないと意味がありません。
| 仕組み | 内容 |
|---|---|
| 件数の日次チェック | 上記のクエリを定期実行し、結果を通知します |
| 0件検知 | 想定より極端に少ない日を検知します |
| ジョブの失敗通知 | スケジュール実行の失敗をチャットに流します |
| 突合 | KARTE 側の管理画面の数字と、取り込んだ件数を月1回照合します |
通知先は、担当者が普段見ている場所にします。メールだと埋もれます。社内チャットに流すほうが読まれます。
通知は異常時のみにします。正常終了の通知を毎日流すと、数日で誰も読まなくなります。
6. リージョンとコストの見落とし
構成の記事でも触れましたが、運用に入ってから効いてくる点として再掲します。
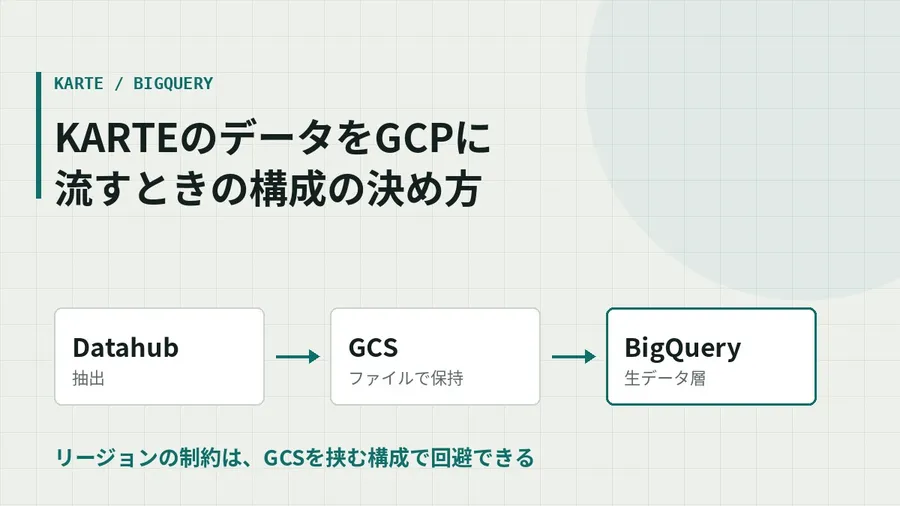
Datahub 側の BigQuery は US マルチリージョンにあります。東京リージョンのデータセットとは直接結合できません。GCS を経由してから取り込む構成にしておくと、この制約を回避できます。
あわせて、GCS のライフサイクルルールを最初に設定します。連携用バケットにファイルがたまり続けると、ストレージ費用が静かに増えます。「30日でNearlineへ、90日で削除」といったルールを置いておけば、後から棚卸しする必要がありません。
まとめ
- 当日分は揃いません。過去数日を毎日取り直す構成にします
- 欠損より重複のほうが気づきにくいです。ユニークキーの重複を毎日数えます
- 名前の対応表を1枚作ります。引き継ぎで一番時間を食うのはここ
- パーティションとクラスタリング、
SELECT *を書かないことでスキャン量が決まります - 通知は異常時のみにします。担当者が普段見ている場所に流します
- リージョンの制約と GCS のライフサイクルは、最初に設定して忘れます
連携は、作るより維持するほうが長いです。壊れたことに気づける仕組みを、作るときに一緒に入れておきます。
参考になったら、いいねを押してください。