
· HARUBOUYA · ai · 6 min read
生成AIの「精度が低い」を直す手順。評価セットと構造化出力から始める
文章を自動生成する仕組みで、出力の質が安定しないときの直し方を説明します。プロンプトを書き直す前に、測る仕組みと出力形式の固定から着手します。
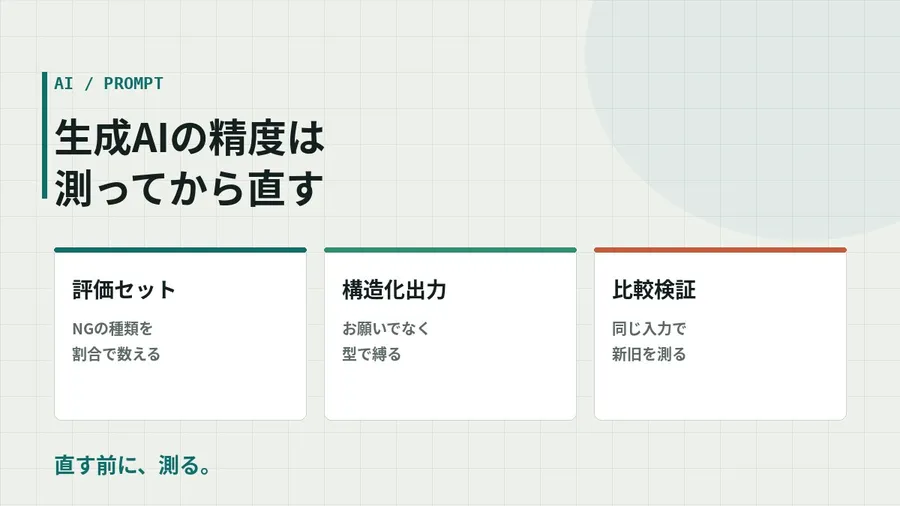
記事や紹介文を自動生成する仕組みを入れたあと、必ず出てくる相談が「なんとなく精度が低い」です。ここを感覚のまま直しにいくと、プロンプトを書き換えては元に戻す堂々巡りになります。
問題
「精度が低い」は、中身の違う不満がひとまとめになった言葉です。
| 実際に起きていること | 本当の原因 |
|---|---|
| 指定した文字数を超えます | 出力形式が自由すぎます |
| 書いていない事実が混ざります | 材料となる情報が不足 |
| 文体がバラつきます | 前提となるルールが毎回変わります |
| 見出しの構成が毎回違います | 出力の型が決まっていません |
| 入れてほしい語句が入りません | 必須条件が指示文に埋もれています |
原因が違えば対策も違います。まず「どのNGが何割起きているか」を数えるところから始めます。
仕組み
改善に必要な部品は3つです。
| 部品 | 役割 |
|---|---|
| 評価セット | 良し悪しを判定するための入力と正解の一覧 |
| 構造化出力 | 出力をJSON形式に固定し、型で縛る機能 |
| 生成パラメータ | 出力の揺れ幅を決める設定値 |
なかでも効くのが構造化出力です。指示文のなかで「30文字以内でお願いします」と頼むより、出力の設計図(スキーマ)で文字数や必須項目を縛るほうが確実です。近年のモデルではPythonのPydanticなどの型定義をそのまま設計図として渡せます。
やること
1. 生成ログから30〜50件を抜き出す
表計算ソフトに「入力条件/生成された文章/NG理由」の3列を作り、実際の出力を貼ります。良い例と悪い例を両方入れます。
2. NG理由を分類して数える
上の表の分類で振り分け、割合を出します。ここで一番多いものが最初に潰す対象です。
3. 出力をJSONに固定する
タイトル、リード文、見出しごとの本文、タグ、のように項目を分けて設計図を書き、生成時に「JSON形式で返す」設定と設計図をセットで渡します。文字数の上限も設計図側に書きます。
4. 指示文を4つに分ける
役割の説明/文体のルール/出力の決まりごと/お手本の実例、の4ファイルに分け、バージョン番号を付けます。1本の長い指示文は、どこを直したか追えなくなります。
5. 新旧を同じ入力で比べる
同じ30件を旧版と新版に流し、機械で測れるもの(文字数、禁止語、必須語句の有無)を自動判定します。判定しづらい読みやすさは、別の生成AIに採点させる方法もあります。
6. 揺れ幅の設定を調整する
安定させたい本文は低め、案を複数出したいタイトルは高め、が出発点です。設定を変えたら必ず同じ30件で測り直します。
失敗例
| やりがちなこと | 起きること |
|---|---|
| 指示文だけ直して終わり | 直した実感はありますが、良くなった証拠が残りません |
| 一度に5か所直します | どの変更が効いたか分かりません |
| 出力の型を決めずに運用開始 | 表示側で毎回レイアウトが崩れます |
| お手本を1件しか入れません | その1件に引きずられた文章ばかりになります |
| 評価を人の目視だけに頼ります | 件数が増えた時点で回らなくなります |
まとめ
- 「精度が低い」は分解して数えるところから
- 出力の型はお願いではなく設計図で縛ります
- 指示文はファイルを分けてバージョンを付けます
- 変更は1回に1か所、同じ入力で新旧を比較
- 評価は機械で測れる部分から自動化
直す前に測ります。それだけで改善は再現できるものに変わります。
参考になったら、いいねを押してください。